Auf den ersten Blick wirkt die Bilanz der KI-Revolution im Unternehmenssektor überwältigend: Aktuellen Branchenerhebungen von VentureBeat Intelligence, McKinsey und Deloitte zufolge setzen mittlerweile rund 88 Prozent der Organisationen künstliche Intelligenz ein, und bis zu 79 Prozent experimentieren aktiv mit autonomen KI-Agenten. Doch ein Blick hinter die Kulissen der Vorstandsetagen offenbart eine massive strukturelle Diskrepanz: Zwischen 85 und 88 Prozent aller Agenten-Pilotprojekte schaffen es niemals in den skalierten Produktivbetrieb.
Warum scheitern vier von fünf Projekten genau an der Schwelle vom beeindruckenden Prototyp zur geschäftskritischen Infrastruktur – und was machen die erfolgreichen Systeme anders?
Das Ende des Modell-Monopols: Intelligenz ist nicht mehr der Flaschenhals
Lange Zeit galt die Faustregel: Wenn ein KI-Agent in der Praxis Fehler macht, braucht man schlicht das nächste, größere Sprachmodell. Diese Annahme ist im Jahr 2026 endgültig widerlegt. Moderne Frontier-Reasoning-Modelle (von OpenAI, Anthropic und Google DeepMind) haben bei komplexen Software- und Logik-Benchmarks wie SWE-bench Verified ein Leistungsniveau erreicht, bei dem die Spitzenmodelle oft nur noch wenige Prozentpunkte auseinanderliegen.
Noch deutlicher zeigt sich dies bei den Kaufentscheidungen der IT-Architekten: Laut Enterprise-Umfragen wählen nur noch rund 2 Prozent der Unternehmen ihre Orchestrierungsplattform wegen eines bestimmten zugrunde liegenden Sprachmodells. Für 78 Prozent sind stattdessen Modell-Agnostik, Ausfallsicherheit, Nachvollziehbarkeit und Governance ausschlaggebend. Nicht die rohe Denkleistung des Modells begrenzt den Erfolg, sondern die fehlende Kontrollarchitektur darum herum.
Vom „Autonomy Race“ zum „Trust Race“: Das Prinzip der Bounded Autonomy
In der ersten Euphoriewelle versuchten viele Entwicklerteams, Agenten mit maximaler, ungebremster Entscheidungsfreiheit (Unconstrained Autonomy) auszustatten. Ein einzelner monolithischer Agent sollte End-to-End auf Datenbanken, APIs und Kundensysteme zugreifen. In der Praxis führte genau dieser Ansatz zu unkalkulierbaren Risiken, Endlosschleifen bei der Token-Nutzung und Compliance-Vetos.
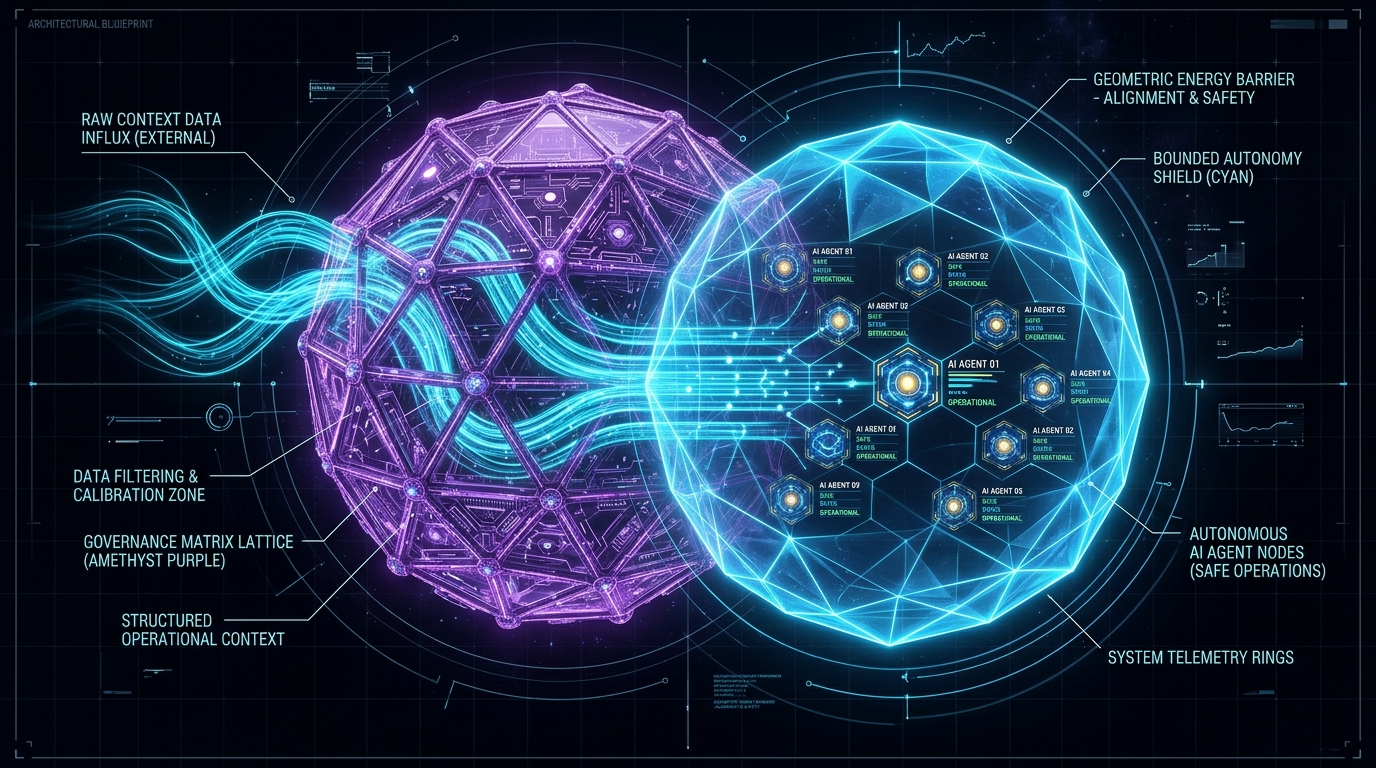
Die führenden rund 15 Prozent der Unternehmen, die Multi-Agenten-Systeme erfolgreich in Produktion betreiben, setzen stattdessen konsequent auf Bounded Autonomy (klar abgegrenzte Autonomie):
- Spezialisierte Rollen-Trennung statt Monolithen: Anstelle eines Allzweck-Agenten arbeiten klar getrennte Spezialisten-Kerne zusammen – ein Prinzip, das auch der KIBOTI-Architektur zugrunde liegt (z. B. Sentinel für OSINT-Scanning, Aurelius für Synthese, Justitia als unabhängige Prüfinstanz und Mercurius für Budget-Kontrolle).
- Unabhängige Control Plane: Sicherheitsregeln, Budget-Limits und Freigabe-Gates liegen außerhalb des Sprachmodells in deterministischen Prüf-Layern.
- Verifizierbare Übergabepunkte: Jeder Agent liefert strukturierte, validierbare Outputs (z. B. strikte JSON-Schemata), bevor der nächste Prozessschritt ausgelöst wird.
Context Engineering als eigentliche Kernkompetenz
Wenn Sprachmodelle zur austauschbaren Standardware (Commodity) werden, verschiebt sich die Wertschöpfung vollständig in das Context Engineering. Ein Reasoning-Modell ist nur so präzise wie der Datenkontext, der ihm im richtigen Moment zur Verfügung steht.
Erfolgreiche Produktionssysteme überfluten das Kontextfenster nicht mit ungefilterten Dokumentenbergen, sondern kuratieren über standardisierte Schnittstellen wie das Model Context Protocol (MCP) exakt jene Fakten, Systemzustände und Richtlinien, die für den jeweiligen Arbeitsschritt relevant sind. Wer die Pipeline aus Datenzulieferung, deterministischer Qualitätsprüfung und klar begrenztem Handlungsspielraum beherrscht, durchbricht die 85-Prozent-Mauer – und verwandelt experimentelle KI-Spielereien in verlässliche Wertschöpfung.
Quelle: VentureBeat Enterprise AI Index & KIBOTI Research Lab
FAQ
Warum scheitern bis zu 88 Prozent der KI-Agenten-Pilotprojekte beim Übergang in die Produktion?
Meist scheitern sie nicht an mangelnder Intelligenz des Sprachmodells, sondern an fehlender Governance, unstrukturiertem Datenkontext, unkontrollierten Kosten-Loops und fehlenden deterministischen Prüfmechanismen (Guardrails).
Was versteht man unter „Bounded Autonomy“?
Bounded Autonomy bezeichnet ein Architekturprinzip, bei dem KI-Agenten innerhalb streng definierter Kompetenzgrenzen, Budgets und Sicherheitsregeln autonom agieren und ihre Ergebnisse durch unabhängige Prüfinstanzen (Audit-Loops) validieren lassen.
Warum wählen 78 Prozent der Unternehmen modellunabhängige Architekturen?
Weil sich die Leistungsfähigkeit der führenden Sprachmodelle stark angeglichen hat. Durch eine modellunabhängige Architektur können Unternehmen jederzeit auf schnellere oder günstigere Modelle wechseln, ohne ihre gesamte Daten- und Agenten-Infrastruktur neu bauen zu müssen.
Tags: #AgenticAI #DeepDive #ContextEngineering #Governance #EnterpriseAI